
RAG là gì? Hướng dẫn RAG cho doanh nghiệp nhỏ bắt đầu
RAG là gì và dùng khi nào? Giải thích retrieval-augmented generation cho người không chuyên: hai pha xây chỉ mục và trả lời, lỗi thường gặp, cách thử nhanh.
Hỏi một mô hình ngôn ngữ lớn (LLM) rằng "cửa hàng tôi đổi trả trong bao lâu?", bạn thường nhận câu trả lời rất chắc chắn. Nhưng LLM không tra cứu gì cả: nó sinh câu trả lời từ trí nhớ đã huấn luyện. Chính sách vừa đổi tuần trước, mô hình vẫn trả lời theo bản cũ — hoặc bịa ra quy định nghe hợp lý.
RAG (Retrieval-Augmented Generation, tạm dịch "sinh tăng cường truy xuất") sửa đúng chỗ đó: mở đúng tài liệu cần thiết, gửi tài liệu đó kèm câu hỏi cho mô hình, rồi mới để mô hình viết câu trả lời dựa trên nó.
Bài này đi từ nền tảng học máy, giải thích RAG từng bước, rồi chốt lại bằng những lỗi hay làm hỏng RAG: dữ liệu bẩn, chunking sai, lệch embedding model, prompt không ràng buộc, và prompt injection.
Nếu bạn chỉ cần công cụ AI dùng được ngay, xem danh sách công cụ AI miễn phí cho doanh nghiệp nhỏ trước khi nghĩ tới việc tự xây.
Từ học máy đến LLM: ba bước cần biết
Học máy (machine learning) là cách để máy tự tìm quy luật từ dữ liệu, thay vì lập trình tay từng quy tắc. Với LLM đó gồm ba bước:
- Dữ liệu. Lượng văn bản lớn làm nguyên liệu thô, chưa gán câu trả lời nào.
- Huấn luyện. Mô hình lặp: dự đoán, so với đáp án thật, điều chỉnh tham số, rồi lặp lại — tốn hàng giờ tới hàng tuần.
- Suy luận (inference). Sau khi huấn luyện xong, mô hình được "chạy" để trả lời câu hỏi mới — lúc bạn gõ câu hỏi và chờ.
Nhiệm vụ huấn luyện rất đơn giản: dự đoán từ khoá tiếp theo (next-token prediction). Với câu "Hà Nội là thủ đô của ...", từ khả năng cao nhất đi sau là "Việt Nam".
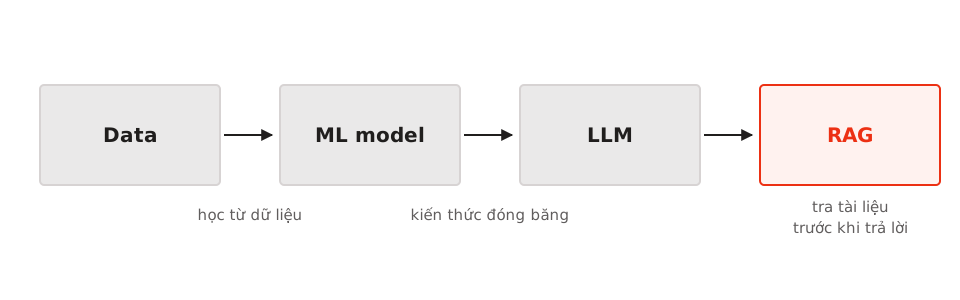
Lặp việc đó trên hàng triệu câu, mô hình nắm được cấu trúc ngôn ngữ, kiến thức chung và mẫu hình suy luận. Nhưng kiến thức bị đóng băng sau khi huấn luyện: nó không tự mở file PDF trên máy bạn. Hỏi về thứ nó không chắc, mô hình vẫn trả lời trôi chảy, tự tin — gốc rễ của ảo giác (hallucination).
RAG là gì?
RAG là viết tắt của Retrieval-Augmented Generation: mở rộng mô hình sinh bằng cách truy xuất thông tin liên quan rồi đưa vào ngữ cảnh trước khi sinh.
Ý tưởng này được định lượng trong bài báo Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks của Lewis và cộng sự năm 2020 — bài báo gốc về RAG của Lewis và cộng sự (2020). RAG vượt trội hơn mô hình đã huấn luyện đầy đủ mà không cần huấn luyện lại.
Có hai vế trong cái tên, và đây là hai phần tách biệt:
- Truy xuất (retrieval): tìm đúng đoạn văn liên quan tới câu hỏi — bài toán "tìm kiếm" của hệ thống tra cứu.
- Sinh (generation): viết câu trả lời tự nhiên, dựa trên đoạn văn vừa tìm được — nhiệm vụ của LLM.
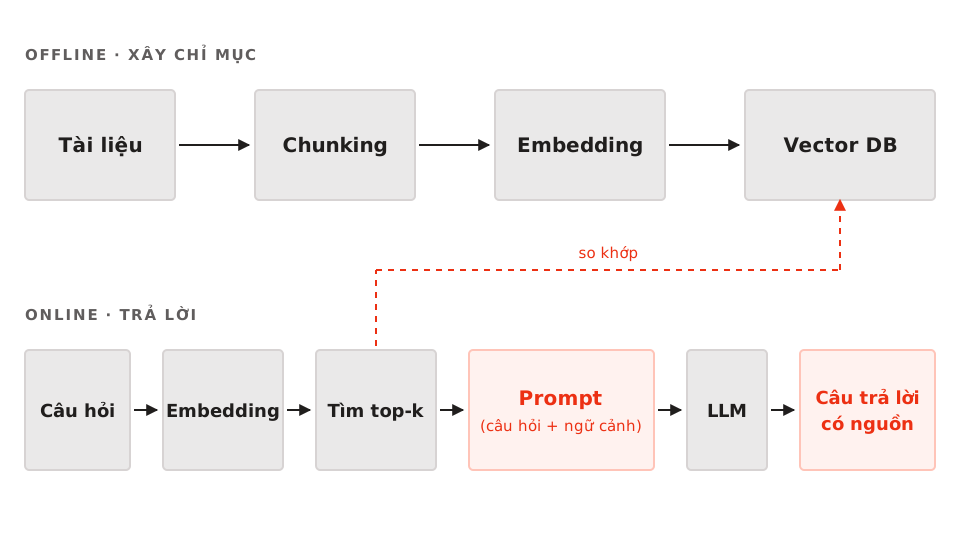
RAG chạy theo hai pha:
- Pha chỉ mục (indexing): cắt nhỏ tài liệu, chuyển thành vector, lưu vào cơ sở dữ liệu vector. Chạy ngoại tuyến (offline), mỗi lần tài liệu đổi.
- Pha truy vấn (query): mỗi lần người dùng hỏi — tra cứu, ghép ngữ cảnh vào prompt, rồi LLM sinh câu trả lời. Chạy trực tuyến (online), phải đủ nhanh.
RAG hoạt động thế nào?
Dưới đây là từng bước, dùng ví dụ chính sách đổi trả của một cửa hàng (file PDF).
1. Cắt nhỏ tài liệu (chunking)
Tài liệu dài không vừa cửa sổ ngữ cảnh (context window) của mô hình, nên được chia thành các đoạn nhỏ gọi là chunk, thường 300–800 token (token tương đương khoảng 3/4 từ tiếng Anh). Cắt theo ranh giới câu, đừng cắt giữa chừng câu: câu bị cắt đôi thì mỗi nửa đều mất nghĩa.
2. Biến đoạn tài liệu thành vector (embedding)
Mỗi chunk được chuyển thành một vector — dãy số mô tả "nghĩa" của đoạn văn đó, nên hai đoạn cùng ý sẽ có vector gần nhau dù khác nhau về từ ngữ. Cách dùng model embedding có trong tài liệu Sentence Transformers.
3. Lưu vào cơ sở dữ liệu vector
Các vector cùng nội dung gốc được lưu vào cơ sở dữ liệu vector, loại cơ sở dữ liệu thiết kế riêng để tìm "vector gần nhất" thật nhanh. Với vài nghìn chunk, một thư viện tìm kiếm gần đúng theo cosine similarity là đủ.
4. Tìm đoạn giống câu hỏi (top-k)
Câu hỏi cũng được chuyển thành vector rồi so với các vector đã lưu. Hệ thống lấy top-k đoạn gần nhất, thường k là 3, 4 hoặc 5, và chỉ đưa những đoạn đó vào prompt.
5. Ghép câu hỏi và ngữ cảnh thành prompt
Prompt cuối cùng có ba phần: chỉ dẫn cho mô hình, câu hỏi của người dùng, và các đoạn trích xuất trong ngữ cảnh — kèm yêu cầu trích dẫn nguồn và từ chối khi tài liệu không đủ.
6. Sinh câu trả lời kèm nguồn
LLM đọc prompt và sinh câu trả lời, kèm tên tài liệu nếu được yêu cầu dẫn nguồn — giúp người đọc kiểm chứng và bạn thấy ngay lỗi hệ thống.
Những lưu ý khi làm RAG
- Dữ liệu sạch, đúng thẩm quyền quan trọng hơn mô hình xịn. RAG chỉ tốt bằng tài liệu bạn đưa vào. Bản PDF cũ hay mâu thuẫn sẽ tạo câu trả lời sai rất tự tin.
- Chunking theo ngữ nghĩa: 300–800 token, chồng lấn 10–15%. Quá nhỏ thì mất bối cảnh, quá lớn thì nhiễu. Vùng chồng lấn giữ câu cuối chunk trước ở đầu chunk sau.
- Dùng cùng model embedding cho lúc index và lúc hỏi. Vector của tài liệu và câu hỏi phải cùng không gian toán học. Đổi model mà không index lại là lỗi âm thầm: không báo lỗi mà chỉ cho kết quả tệ.
- Dùng tìm kiếm lai (hybrid search) rồi rerank. Vector giỏi với câu hỏi diễn đạt lại, dở với từ khóa hiếm. Kết hợp BM25 (chấm điểm theo từ khóa kinh điển) với vector rồi xếp lại kết quả sẽ tốt hơn rõ rệt; bước xếp lại đó chính là cross-encoder. Chi tiết về dense và sparse search giải thích vì sao hai cách tìm này bổ sung cho nhau.
- Prompt phải buộc dẫn nguồn và từ chối khi thiếu dữ liệu. Chỉ trả lời từ ngữ cảnh được cung cấp, trích dẫn nguồn, nói rõ khi tài liệu không đủ.
- Đo bằng bộ câu hỏi vàng. Viết 20–50 câu hỏi có đáp án đúng, rồi đo recall@k (k đoạn lấy ra có chứa đáp án không), groundedness (câu trả lời có bám nguồn không) và độ trễ.
- Coi chi phí, quyền riêng tư và quyền truy cập là một phần của bài toán. Lọc quyền truy cập trước khi đưa đoạn tài liệu vào prompt: ai không được đọc bản lương của đồng nghiệp thì hệ thống không nên tra được nó. Tài liệu độc hại còn chứa chỉ dẫn giả mạo (prompt injection).
Khi nào chưa cần RAG
| Cách làm | Chi phí | Độ tươi dữ liệu | Khi nào nên chọn |
|---|---|---|---|
| Nhét tài liệu vào prompt | Thấp | Tức thì | Tài liệu ít, ngắn, hay đổi |
| RAG | Trung bình, phải duy trì chỉ mục | Vài phút tới vài giờ | Nhiều tài liệu, cần trả lời có nguồn |
| Fine-tune | Cao, cần dữ liệu và GPU | Phải huấn luyện lại | Đổi văn phong, định dạng đầu ra; không dùng để nhồi kiến thức |
Tài liệu chỉ vài trang và hay đổi thì nhét thẳng vào prompt. Cần trả lời "theo tài liệu này" kiểm toán được thì hãy làm RAG. Đừng dùng fine-tune để nhồi kiến thức mới — cách đắt nhất để cập nhật.
Checklist thử RAG trong một buổi
- Thu 20–50 tài liệu thật — đúng những gì người dùng hay hỏi: FAQ, quy chế, báo giá.
- Cắt chunk thử 2–3 kích thước (300, 500, 800 token) và đánh số mục.
- Index vào kho vector, rồi thử 3–5 câu hỏi thật và đọc kết quả.
- Viết 10 câu hỏi vàng kèm câu trả lời kỳ vọng, gồm 2–3 câu tài liệu không có đáp án.
- Đo recall@k và đọc tay 10 câu trả lời. Đoạn đúng mà câu sai thì lỗi ở prompt; đoạn sai thì lỗi ở chunking hay tìm kiếm.
Câu hỏi thường gặp
RAG có hết ảo giác không?
Không. RAG giảm ảo giác chứ không xóa: đoạn lấy ra sai thì mô hình vẫn trả lời sai. Giảm rủi ro bằng lớp ràng buộc: buộc dẫn nguồn, cho phép nói "không có trong tài liệu", kiểm tra câu trả lời có bám nguồn không.
RAG khác tìm kiếm Google thế nào?
Tìm kiếm Google trả về danh sách trang để bạn tự đọc. RAG trả về câu trả lời đã tổng hợp, kèm nguồn trích dẫn, và chỉ dùng tài liệu bạn kiểm soát.
Cần vector database riêng không?
Không nhất thiết. Với vài nghìn chunk, một thư viện tìm kiếm vector nhúng trong ứng dụng là đủ, và nhiều dịch vụ AI có sẵn kho vector theo gói. Cân nhắc kho riêng khi tài liệu lớn, nhiều người hỏi đồng thời, hoặc cần độ trễ ổn định.
Kết luận
RAG không phải phép màu: đó là cách đưa tài liệu của bạn vào câu trả lời của LLM theo thứ tự có kiểm soát — tra cứu trước, rồi mới viết. Phần khó nằm ở dữ liệu, cách cắt chunk, cách tìm kiếm và cách đo chất lượng; làm đúng bốn điều đó trước khi đầu tư mô hình đắt hơn. Nếu bạn mới bắt đầu và cần một trợ lý AI dùng được ngay mà không phải tự xây hệ thống, hãy xem hướng dẫn dùng ChatGPT cho chủ doanh nghiệp.