
Cross-encoder là gì? Rerank trong RAG và bi-encoder
Cross-encoder là gì, khác gì bi-encoder, vì sao RAG cần rerank, chi phí độ trễ và cách đo bằng nDCG@10. áp dụng khi tìm lại đoạn hợp đồng và mẫu đơn bán hàng.

Vector search trả về những đoạn trông liên quan; đọc kỹ thì nhiều đoạn đúng chủ đề nhưng sai chi tiết. Truy xuất có hai bài toán tách biệt: recall (có lôi ra được đoạn trả lời không) và precision (đoạn đúng nhất có nằm đầu không). Một bước quét nhanh giỏi recall; một bước chấm chậm giỏi precision. Đó là bi-encoder và cross-encoder. Chưa nắm RAG thì đọc hướng dẫn RAG cho doanh nghiệp nhỏ trước.
Bi-encoder là gì?
Bi-encoder mã hoá câu hỏi và tài liệu độc lập bằng cùng bộ trọng số, mỗi bên một lần forward, ra hai vector; độ liên quan là dot product hoặc cosine.
Vector tài liệu được tính trước lúc xây chỉ mục. Lúc hỏi, hệ thống chỉ nhúng câu hỏi một lần rồi tra ANN, nên chi phí mỗi truy vấn gần như không đổi khi kho phình từ một nghìn lên một triệu đoạn.
Đổi lại, bi-encoder nén mất chi tiết: đoạn 400 token thành vector 768 chiều, không còn chỗ cho tương tác từng token. Hỏi "đổi trả trong bao nhiêu ngày?" thì "Đổi trả trong 14 ngày" và "Hoàn tiền xử lý trong 14 ngày" đều gần câu hỏi như nhau, dù chỉ đoạn đầu trả lời đúng. Nó không kiểm tra được "14 ngày" thuộc về "đổi trả" hay "hoàn tiền".
Cross-encoder là gì?
Cross-encoder ghép câu hỏi và tài liệu thành một chuỗi — [CLS] câu hỏi [SEP] tài liệu [SEP] — rồi cho cả chuỗi qua transformer trong một lần forward. Attention thấy mọi token hai bên cùng lúc nên mỗi token câu hỏi đối chiếu trực tiếp với cụm từ liên quan. Đầu ra là một số vô hướng: điểm liên quan của cặp.
Với câu hỏi trên, nó đọc "14 ngày" trong ngữ cảnh "hoàn tiền" và chấm đoạn đó thấp hơn hẳn; nó cũng bắt được phủ định ("không áp dụng cho hàng khuyến mãi") và điều kiện ("chỉ khi còn tem").
Cái giá: không tính trước được, vì điểm phụ thuộc vào cặp cụ thể. Chi phí là O(N) lần forward cho N ứng viên — rerank 100 đoạn thì ổn, rerank một triệu đoạn mỗi câu hỏi là bất khả thi về độ trễ lẫn tiền. Vì thế cross-encoder chỉ dùng ở giai đoạn hai, trên danh sách ngắn do bi-encoder hoặc BM25 lọc ra.
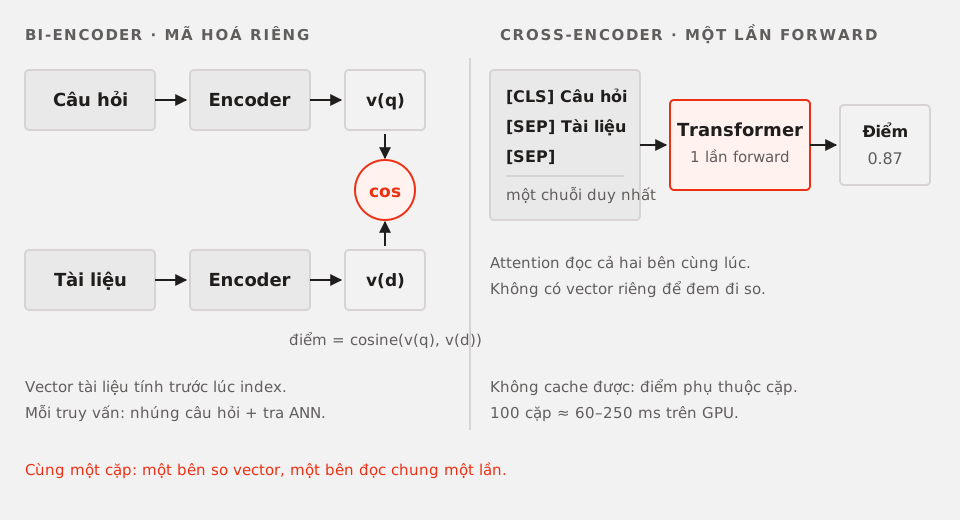
Hình 1. Bên trái: bi-encoder mã hoá riêng rồi so vector. Bên phải: cross-encoder ghép cả hai vào một lần forward và ra điểm.
Bảng so sánh
| Tiêu chí | Bi-encoder | Cross-encoder |
|---|---|---|
| Đầu vào | Câu hỏi và tài liệu riêng, hai lần forward | Một chuỗi ghép [query, document] |
| Chạy khi nào | Tài liệu: lúc index. Câu hỏi: mỗi truy vấn | Mỗi cặp, mỗi truy vấn, không cache được |
| Tính trước | Có, cho toàn bộ kho | Không |
| Chi phí mỗi truy vấn | 1 lần nhúng + 1 lần ANN, khoảng 10–40 ms cho 1 triệu vector | N lần forward: 100 cặp khoảng 60–250 ms trên GPU |
| Độ chính xác xếp hạng | Khá, mất chi tiết token | Cao hơn rõ rệt trên cặp khó |
| Phù hợp nhất | Lọc thô toàn kho, tối ưu recall | Xếp lại danh sách ngắn, tối ưu precision |
| Dùng điển hình | Lấy top 50–100 ứng viên | Chốt top 3–5 đưa vào prompt |
Pipeline hai giai đoạn
- Truy xuất thô: chạy BM25 và dense song song, hợp nhất RRF, lấy top 50–100. Ưu tiên tốc độ và độ phủ.
- Xếp lại: đưa 50–100 cặp qua cross-encoder, sắp theo điểm, cắt top 3–5.
- Sinh: chỉ 3–5 đoạn đó vào prompt của LLM.
Rerank 100 cặp làm được vì chi phí tuyến tính theo số ứng viên: một GPU nhỏ xử lý trong vài chục tới vài trăm mili giây; một triệu cặp thì nhân lên mười nghìn lần. Con số 100 cũng hợp lý vì recall bước một thường đã đạt 90–95% trong top 100.
Ngân sách độ trễ: nhúng câu hỏi 10–30 ms, BM25 5–15 ms, ANN 10–40 ms, rerank 100 cặp 60–250 ms, LLM 1–3 giây. Ngân sách dưới 500 ms thì giảm còn 20–30 ứng viên trước khi bỏ hẳn.
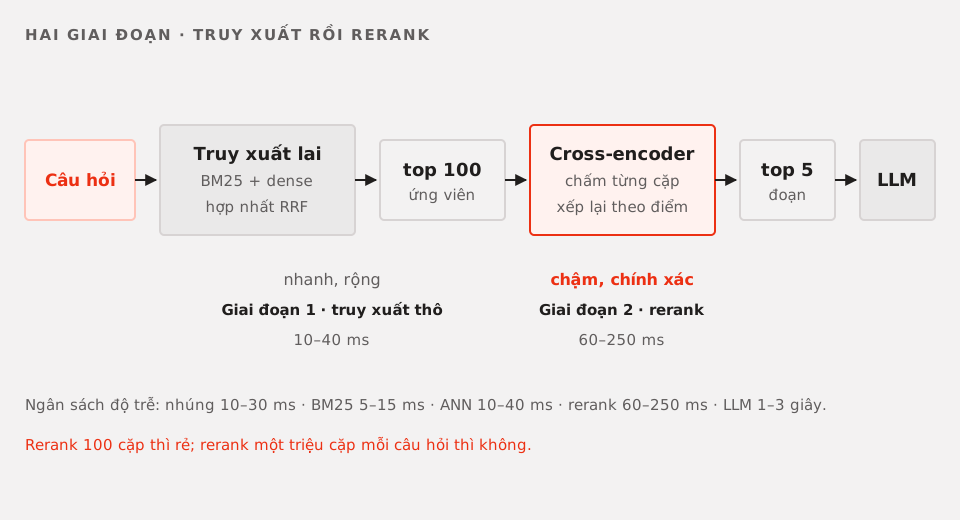
Hình 2. Truy xuất lai lấy top 100, cross-encoder xếp lại, còn top 5 cho LLM. Nửa trái nhanh và rộng, nửa phải chậm và chính xác.
Phía trước còn dư địa: kỹ thuật HyDE trong RAG cho LLM viết trước một đoạn giả định rồi nhúng đoạn đó thay câu hỏi gốc, cách hợp nhất hai bảng điểm BM25 và dense có trong bài dense và sparse search.
Code tối thiểu
Thư viện sentence-transformers có lớp CrossEncoder, đúng thứ cần cho giai đoạn hai:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("BAAI/bge-reranker-v2-m3", max_length=512)

def rerank(query: str, candidates: list[dict], top_k: int = 5, min_score: float = 0.0):
    pairs = [(query, c["text"]) for c in candidates]
    scores = reranker.predict(pairs, batch_size=32, show_progress_bar=False)
    ranked = sorted(zip(candidates, scores), key=lambda item: item[1], reverse=True)
    return [(c, float(s)) for c, s in ranked[:top_k] if s >= min_score]
Batch 32 nhanh hơn nhiều lần so với chạy từng cặp, và ngưỡng min_score phải hiệu chỉnh trên dữ liệu thật vì predict trả về logit, không phải xác suất.
Chọn model và tiếng Việt
Với kho tiếng Việt, tiêu chí đầu tiên là model đa ngôn ngữ. BAAI/bge-reranker-v2-m3 hỗ trợ nhiều ngôn ngữ và nhận đầu vào dài; các bản ms-marco-MiniLM chỉ huấn luyện trên tiếng Anh. Dùng reranker tiếng Anh cho kho tiếng Việt không báo lỗi, không crash — nó chỉ xếp hạng kém hơn âm thầm.
Độ dài đầu vào là bẫy thứ hai. Phần lớn cross-encoder cắt ở 512 token; phần vượt bị bỏ, và điều kiện quan trọng nằm ở cuối đoạn sẽ biến mất. bge-reranker-v2-m3 nhận tới 8192 token nhưng chi phí tăng theo độ dài, nên chunk 300–500 token vẫn là điểm cân bằng tốt.
Thứ ba là tokenizer và dấu thanh: có dấu và không dấu là hai chuỗi khác nhau, nên nếu kho trộn cả hai kiểu thì phải kiểm tra model xử lý ổn cả hai. Cách thực dụng: lấy 20 cặp câu hỏi – đoạn văn, chạy qua model và đọc điểm.
Đo hiệu quả
Dựng bộ câu hỏi vàng 20–50 câu, mỗi câu gắn đoạn tài liệu đúng, rồi đo bốn thứ:
- nDCG@10: chất lượng thứ tự trong 10 kết quả đầu — đoạn đúng có nằm đầu hay chỉ có mặt.
- recall@k: đoạn đúng có trong k kết quả không. Đo trước và sau rerank để biết lấy lại được bao nhiêu.
- Độ trễ p95: không phải trung bình. Người dùng cảm nhận đuôi chậm, và rerank dễ tạo đuôi dài nếu batch sai.
- Chi phí trên 1.000 truy vấn: số cặp phải chấm nhân giá mỗi lần forward, cộng tiền GPU thuê theo giờ.
Cách đo đáng tin nhất là A/B trên cùng bộ câu hỏi: một lượt không rerank, một lượt có, so nDCG@10 và p95. Chênh lệch dưới 0,02 thường là nhiễu. Quan trọng không kém: đọc tay 20 kết quả tệ nhất — bảng số không cho biết rerank sai vì chunk bị cắt hay vì tài liệu gốc mâu thuẫn.
Các bài báo thường báo tăng vài điểm nDCG trên dữ liệu tiếng Anh, miền cụ thể. Mức tăng đó không tự động chuyển sang kho của bạn: khác ngôn ngữ, khác chunk, khác kiểu câu hỏi.
Khi nào không cần rerank
Rerank đáng làm trong phần lớn hệ RAG, nhưng không phải mọi hệ.
- Kho rất nhỏ. Vài chục tài liệu thì nhét thẳng vào prompt rẻ hơn dựng model.
- Ngân sách độ trễ rất chặt. Cần trả lời dưới 300 ms thì thêm 100–250 ms là không khả thi.
- Streaming. Câu trả lời đã chảy về màn hình trước khi rerank xong thì rerank chỉ làm chậm chữ đầu.
- Tra cứu mã chính xác. Mã đơn, SKU, số hợp đồng: BM25 đã làm đúng, không cần thêm.
Cần công cụ dùng ngay thay vì tự dựng pipeline thì danh sách công cụ AI miễn phí cho doanh nghiệp nhỏ là điểm bắt đầu rẻ hơn.
Câu hỏi thường gặp
Cross-encoder có thay vector database không?
Không. Vector database lưu và tìm gần đúng trên hàng triệu vector — hạ tầng của bước truy xuất thô. Cross-encoder không lưu gì, không tìm gì; nó chỉ chấm điểm một cặp văn bản đã có. Bỏ vector database thì mất khả năng quét toàn kho; bỏ cross-encoder thì mất bước tinh chỉnh.
Rerank có làm chatbot chậm không?
Có, nhưng thường ít hơn bạn lo. Rerank 50–100 cặp tốn 60–250 ms trên GPU, trong khi LLM cần 1–3 giây để sinh. Trả lời đúng ngay lần đầu rẻ hơn nhiều so với hỏi lại. Nếu độ trễ là vấn đề, giảm ứng viên và tăng batch trước khi bỏ rerank.
Có cần fine-tune cross-encoder không?
Thường là không ở giai đoạn đầu: model đa ngôn ngữ có sẵn đã đủ tốt. Chỉ cân nhắc khi có ít nhất vài trăm cặp đã gán nhãn đúng/sai, và khi lỗi còn lại mang tính hệ thống — ví dụ model luôn xếp đoạn mô tả sản phẩm lên trên đoạn chính sách. Fine-tune trên dữ liệu ít và bẩn thường tệ hơn model gốc.
Kết luận
Bi-encoder quét rộng và rẻ, cross-encoder đọc kỹ và đắt; RAG dùng cả hai theo thứ tự đó. Nếu đang bắt đầu, hãy dựng pipeline hai giai đoạn với 50–100 ứng viên, chọn reranker đa ngôn ngữ, rồi đo bằng bộ câu hỏi vàng của chính bạn. Cần người thiết kế và vận hành phần này, đội ngũ kỹ thuật của Cross Tech Edu nhận từ chọn model tới đo lường định kỳ.