
Chunking là gì? Cắt tài liệu cho RAG đúng cách cho shop
Chunking là gì, chọn kích thước và overlap ra sao, cắt theo cấu trúc, parent-child và cách đo bằng recall@k. ví dụ trên hợp đồng và sách hướng dẫn của cửa hàng.

Truy xuất chỉ trả về được những gì nằm trong một chunk. Nếu ranh giới cắt rơi đúng giữa câu trả lời, hệ thống hoặc không tìm thấy đoạn đó, hoặc đưa cho LLM một nửa câu rồi để nó tự đoán phần còn lại. Chunking vì thế là bước quyết định chất lượng của cả pipeline. Chưa nắm RAG thì đọc hướng dẫn RAG cho doanh nghiệp nhỏ trước.
Chunking là gì?
Chunking là chia tài liệu dài thành các đoạn nhỏ, mỗi đoạn là một đơn vị độc lập cho ba việc: nhúng thành vector, tìm kiếm, và trích dẫn nguồn. Một chunk tốt đủ hẹp để vector mô tả đúng một ý, đủ rộng để ý đó đứng một mình.
Kích thước là bài toán đánh đổi, không có con số đúng cho mọi kho: chunk nhỏ cho vector sắc nhưng thiếu ngữ cảnh; chunk lớn giữ ngữ cảnh nhưng vector bị pha loãng và prompt bị nhồi.
Vì sao chunking quyết định chất lượng RAG
- Chunk quá nhỏ thì mất ngữ cảnh. Đoạn "áp dụng trong 14 ngày" không cho biết 14 ngày tính từ lúc nào hay cho việc gì. Vector của nó gần như vô nghĩa.
- Chunk quá lớn thì pha loãng tín hiệu. Một vector 768 chiều gói cả ba chủ đề trong 1.500 token; câu hỏi về chủ đề thứ ba chỉ khớp một phần, nên điểm thấp và đoạn đúng rơi khỏi top-k. Chưa kể 5 chunk × 1.500 token là 7.500 token nhồi vào prompt.
- Ranh giới cắt đôi câu trả lời. Câu hỏi cần hai câu liền nhau, mỗi câu nằm một chunk, không chunk nào đủ trả lời.
- Mất tiêu đề thì mất nghĩa. Đoạn "Bước 3: gửi email xác nhận" chỉ hiểu được khi biết nó thuộc quy trình đổi trả hay tuyển dụng.
Ba cách cắt
Cắt theo kích thước cố định. Đếm token rồi cắt mỗi N token, thêm overlap. Nhanh, dễ code, chạy với mọi định dạng — nhưng hay cắt giữa câu và không biết gì về cấu trúc.
Cắt theo cấu trúc. Cắt tại tiêu đề, hết đoạn, hết mục danh sách, ranh giới bảng. Chunk giữ đơn vị nghĩa tự nhiên, đổi lại phụ thuộc parser và độ dài mục không đều.
Cắt theo ngữ nghĩa. Nhúng từng câu, đo độ tương đồng giữa câu liền kề, cắt chỗ chủ đề đổi. Bám chủ đề hơn nhưng tốn một lượt nhúng cho cả tài liệu và khó giải thích khi sai.
| Cách | Ưu | Nhược | Khi dùng |
|---|---|---|---|
| Kích thước cố định | Nhanh, đơn giản, mọi định dạng | Cắt giữa câu, bỏ qua cấu trúc | Bản nháp đầu tiên, văn bản không cấu trúc |
| Theo cấu trúc | Giữ nguyên đơn vị nghĩa, dễ trích dẫn | Phụ thuộc parser, mục dài ngắn khác nhau | Markdown, HTML, tài liệu có tiêu đề |
| Theo ngữ nghĩa | Bám chủ đề, ít lẫn nội dung | Tốn tính toán, khó giải thích | Văn bản dài, không có tiêu đề rõ |
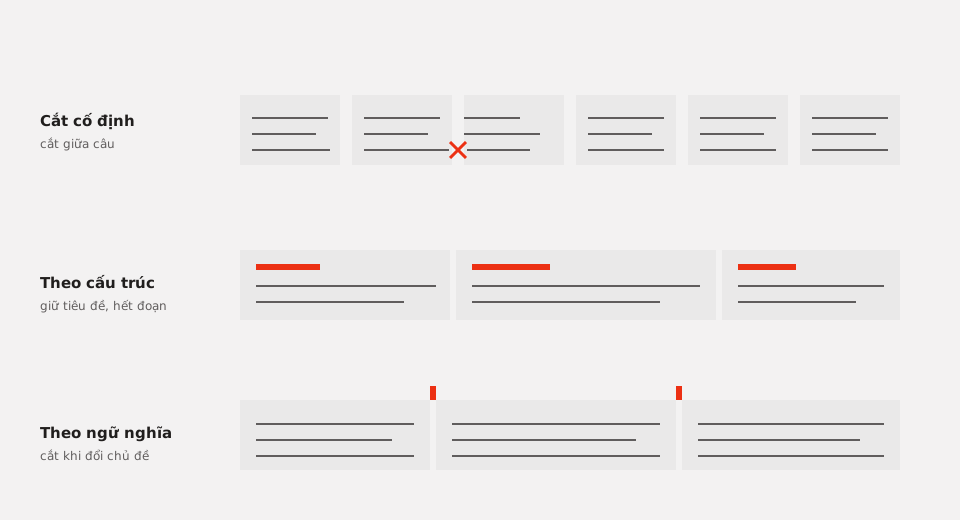
Hình 1. Cùng một tài liệu, ba kiểu ranh giới. Cách cắt cố định làm đứt một câu; hai cách còn lại giữ được đơn vị nghĩa.
Chọn kích thước và overlap
Khoảng 300–500 token là điểm khởi đầu hợp lý khi model của bạn giới hạn 512 token; dùng tới 800 token chỉ khi model nhận đầu vào dài (8k trở lên). Dưới 300, ngữ cảnh thường thiếu; trên 800, vector bắt đầu pha loãng và chi phí prompt tăng nhanh.
Overlap 10–15% giúp câu bị cắt ở cuối chunk trước xuất hiện nguyên vẹn ở đầu chunk sau. Đừng lạm dụng: overlap 50% nghĩa là mỗi ý được nhúng hai lần, top-k đầy bản trùng lặp và prompt bị chiếm chỗ.
Với tiếng Việt, đừng đo bằng ký tự: cùng độ dài ký tự, tiếng Việt tốn nhiều token hơn tiếng Anh vì dấu thanh và cách tokenizer tách âm tiết. Hãy đếm bằng đúng tokenizer của model bạn dùng.
Cuối cùng là giới hạn cứng của model: nhiều model cũ (MiniLM, E5) cắt ở 512 token, còn các model mới như text-embedding-3 (8.191) hay BGE-M3 (8.192) nhận đầu vào dài hơn nhiều. Kiểm tra max input của đúng model bạn dùng; nếu là 512, chunk 800 token sẽ bị cắt cụt lúc nhúng hoặc rerank, và phần bị bỏ thường là phần cuối — nơi điều kiện quan trọng hay nằm.
Cắt theo cấu trúc tài liệu
Với Markdown, cắt tại dòng tiêu đề và giữ đường dẫn tiêu đề trong metadata (Chính sách đổi trả > Thời hạn > Hàng khuyến mãi). Tiền tố này khôi phục ngữ cảnh mà không tốn nhiều token.
Với HTML, dùng thẻ tiêu đề và khối văn bản thay vì bóc sạch thẻ. Với PDF, trích theo bố cục — cắt mù trên text đã bóc thường trộn hai cột vào một dòng.
Ba quy tắc thực dụng: giữ nguyên bảng và lặp lại hàng tiêu đề ở mỗi chunk nếu bảng buộc phải chia; không tách danh sách khỏi câu dẫn ("Các giấy tờ cần nộp:" phải đi cùng danh sách); không để chunk vượt giới hạn token của model nhúng.
Parent-child (small-to-big)
Cách này tách đôi hai nhu cầu mâu thuẫn: khớp chính xác cần đơn vị nhỏ, trả lời cần ngữ cảnh lớn.
Bạn index các chunk con nhỏ — một đoạn, một mục — để vector bám sát nội dung, và mỗi chunk con trỏ về chunk cha là cả mục lớn chứa nó. Khi truy vấn khớp một chunk con, hệ thống đưa chunk cha cho LLM.
Kết quả: tìm kiếm sắc như chunk 150 token, ngữ cảnh đầy đủ như chunk 1.000 token, prompt chỉ chứa một mục thay vì năm mẩu rời rạc.
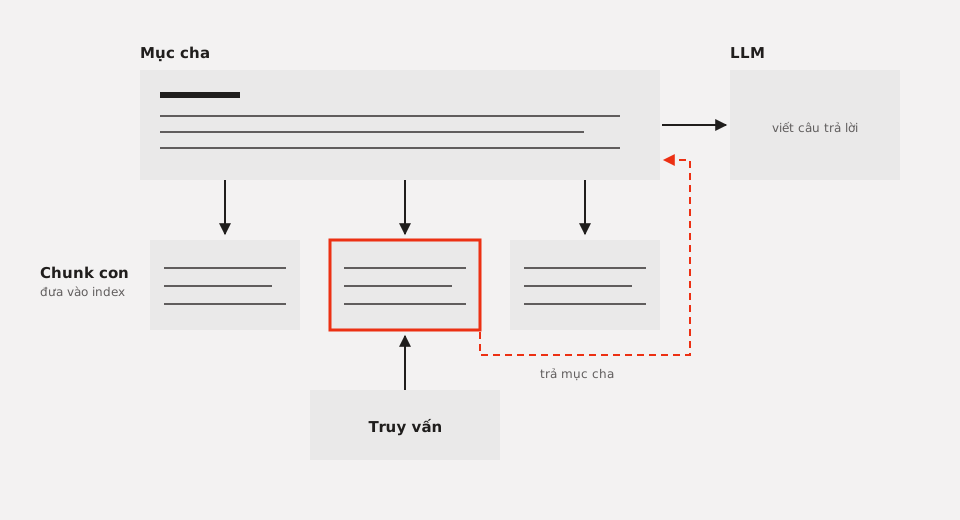
Hình 2. Hai tầng: tầng index gồm các chunk con, tầng trả lời gồm chunk cha. Truy vấn khớp ở tầng dưới, LLM đọc ở tầng trên.
Code tối thiểu
Đoạn dưới cắt theo tiêu đề, rồi gom đoạn văn cho tới khi đầy ngân sách token, kèm overlap:
import re
import tiktoken

enc = tiktoken.get_encoding("cl100k_base")

def ntok(text: str) -> int:
    return len(enc.encode(text))

def split_sections(md: str) -> list[str]:
    # a heading stays with the text that follows it
    parts = re.split(r"(?m)^(?=#{1,3} )", md)
    return [p.strip() for p in parts if p.strip()]

def pack(section: str, budget: int = 500, overlap: int = 60) -> list[str]:
    paras = [p.strip() for p in re.split(r"\n\s*\n", section) if p.strip()]
    chunks, buf = [], ""
    for p in paras:
        if buf and ntok(buf + "\n\n" + p) > budget:
            chunks.append(buf)
            tail = enc.decode(enc.encode(buf)[-overlap:])
            buf = tail + "\n\n" + p
        else:
            buf = f"{buf}\n\n{p}" if buf else p
    if buf:
        chunks.append(buf)
    return chunks

chunks = [c for s in split_sections(md) for c in pack(s)]
Hai điểm cần chỉnh: budget phải nhỏ hơn giới hạn embedder (500 token an toàn với model 512), và overlap nên là 10–15% của budget. Mục có một đoạn dài hơn budget vẫn tạo chunk vượt ngân sách — cần thêm bước cắt đoạn quá dài theo câu.
Đo chất lượng chunking
Dựng bộ câu hỏi vàng 20–50 câu, mỗi câu gắn đoạn tài liệu chứa đáp án, rồi đo:
- recall@k trước và sau khi đổi cách cắt. Chỉ số trực tiếp nhất: chunking tốt làm đoạn đúng vào top-k nhiều hơn.
- Đáp án có nằm trọn trong một chunk không. Nếu phải ghép hai chunk mới đủ, ranh giới đang sai.
- Phân bố kích thước chunk. Vài chunk 20 token cạnh vài chunk 3.000 token là dấu hiệu parser hỏng.
- Chunk mồ côi. Không tiêu đề, không ngữ cảnh, hoặc chỉ còn dấu câu — đếm xem chúng có chiếm top-k không.
Cách chắc chắn nhất là A/B hai cấu hình trên cùng bộ câu hỏi: 400 so với 700 token, có và không tiền tố tiêu đề. Đọc tay 20 kết quả tệ nhất để biết lỗi nằm ở ranh giới hay ở bước sau. Nếu top-100 đã có đoạn đúng mà thứ hạng còn kém, vấn đề không còn là chunking — đó là lúc thêm cross-encoder để xếp lại kết quả.
Lỗi thường gặp
- Cắt giữa câu vì đếm ký tự thay vì cắt tại dấu câu.
- Chunk lớn hơn giới hạn model nên bị cắt cụt âm thầm.
- Overlap quá lớn khiến cùng một nội dung chiếm ba suất trong top-k và prompt.
- Không lưu tiêu đề vào metadata nên chunk mất ngữ cảnh.
- Chia bảng giữa các hàng mà không lặp lại hàng tiêu đề, khiến số liệu mất nghĩa.
- Một chunk cho cả trang, biến mỗi vector thành trung bình cộng mọi chủ đề.
Câu hỏi thường gặp
Chunk size bao nhiêu là tốt?
Không có con số chung. Bắt đầu ở 400–500 token với overlap 10%, đo recall@k, rồi thử 300 và 700 trên cùng bộ câu hỏi vàng. FAQ ngắn hợp chunk nhỏ; chính sách nhiều điều kiện hợp chunk lớn hơn.
Có cần overlap không?
Có, nhưng ít. Overlap 10–15% đủ cứu câu bị cắt ở ranh giới. Nếu cắt theo cấu trúc và mỗi chunk đã trọn một mục, có thể giảm gần 0 mà không mất gì.
Chunk theo token hay ký tự?
Theo token. Ký tự không tương ứng với chi phí thật của model, và với tiếng Việt tỉ lệ token trên ký tự lệch còn nhiều hơn. Đếm bằng tokenizer của chính model bạn dùng.
Kết luận
Chunking là nơi chất lượng RAG được quyết định sớm nhất và rẻ nhất: cắt đúng ranh giới, giữ tiêu đề, chọn kích thước bằng token thật, rồi đo bằng recall@k. Làm bốn việc đó trước khi đổi model hay thêm tầng rerank. Cần người làm giúp từ khâu cắt tài liệu tới đo lường, đội ngũ kỹ thuật của Cross Tech Edu nhận cả pipeline. Chỉ cần công cụ dùng ngay thì xem danh sách công cụ AI miễn phí cho doanh nghiệp nhỏ.