
Dense search là gì? So sánh với sparse search trong RAG
Dense search là gì? So sánh với sparse search (BM25) trong RAG: cách biểu diễn, điểm mạnh yếu, hybrid RRF, cách đo và lưu ý tiếng Việt cho doanh nghiệp nhỏ.

Dense search dùng vector embedding để so nghĩa; sparse search dùng từ khóa (BM25) để so chuỗi. Cả hai đều tìm đoạn văn liên quan trong RAG, nhưng mạnh ở hai loại câu hỏi khác nhau: dense cho câu hỏi diễn đạt lại, sparse cho mã và thuật ngữ chính xác.
Chưa nắm RAG thì đọc hướng dẫn RAG cho doanh nghiệp nhỏ trước; bài này đi sâu vào bước truy xuất.
Sparse search là gì?
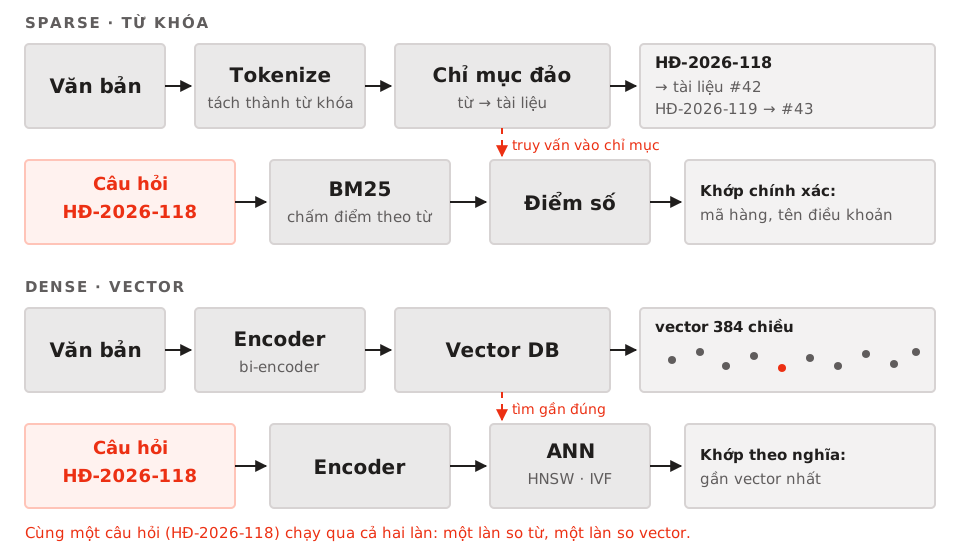
Sparse search (tìm kiếm thưa) rút gọn văn bản thành túi từ: mỗi tài liệu chỉ còn danh sách từ kèm tần suất, bỏ qua thứ tự từ và ngữ pháp.
Để tìm nhanh, hệ thống dựng inverted index (chỉ mục đảo): bảng tra từ khóa → danh sách tài liệu chứa từ đó. Truy vấn được tách thành từ rồi tra chỉ mục để cộng điểm.
Điểm kinh điển là TF-IDF: tần suất của từ nhân với độ hiếm của từ trong kho. Ngày nay dùng BM25 làm chuẩn, gồm tần suất bão hòa, trọng số ngược độ hiếm và độ dài tài liệu.
Điểm mạnh:
- Khớp chính xác. Mã hợp đồng, số hiệu, tên riêng chỉ lộ ra khi so chuỗi ký hiệu.
- Giải thích được. Bạn biết tài liệu trúng vì từ khóa nào.
- Rẻ và nhanh. Không cần model, không GPU, tài liệu mới vào index là xong.
Điểm yếu:
- Không hiểu nghĩa. Hỏi "bao lâu thì được đổi" mà tài liệu viết "thời hạn trả lại hàng" — không chung từ khóa nên rơi ngoài top-k.
- Nhiễu từ dừng. "của", "là", "và" ở mọi nơi làm loãng điểm số.
- Đồng nghĩa phải khai báo tay. "Đổi trả" và "hoàn hàng" phải được khai báo thủ công.
Dense search là gì?
Dense search (tìm kiếm dày) không đếm từ, mà nhúng văn bản thành một vector số cố định — thường 384, 768 hoặc 1024 chiều. Mô hình bi-encoder nhúng câu hỏi và tài liệu độc lập bằng cùng bộ trọng số; bài báo SBERT trên arXiv là điểm khởi đầu thường được nhắc tới.
Vector tài liệu được lưu trong cơ sở dữ liệu vector; câu hỏi cũng được nhúng rồi tìm các vector gần nhất. Duyệt toàn bộ kho quá chậm, nên dùng tìm kiếm gần đúng (ANN) với HNSW hoặc IVF, đánh đổi chút chính xác lấy tốc độ.
Điểm mạnh:
- Hiểu nghĩa. "Đổi trả" và "hoàn hàng" nằm gần nhau trong không gian vector dù không chung từ nào.
- Chịu được câu hỏi diễn đạt lại. Hỏi nhiều cách khác nhau vẫn ra cùng kết quả.
- Đa ngôn ngữ tốt hơn. Model đa ngôn ngữ xếp hạng câu hỏi tiếng Việt cùng tài liệu tiếng Anh trong một không gian.
Điểm yếu:
- Mã và số gần như vô nghĩa với vector. Chuỗi "HĐ-2026-118" không tạo ra tín hiệu khác biệt, nên dense hay trượt khi cần khớp chính xác.
- Tốn nhiều hơn. Cần model embedding, kho vector, và thời gian embed lại kho khi đổi model.
- Khó giải thích. Điểm số chỉ là độ gần giữa các vector, không chỉ ra lý do cụ thể.
So sánh trực tiếp
Hai bên này trả lời hai câu hỏi khác nhau, không phải hai phiên bản của cùng một thứ.
| Tiêu chí | Sparse search | Dense search |
|---|---|---|
| Biểu diễn | Túi từ, đếm tần suất | Vector embedding nén nghĩa |
| Kiểu khớp | Chính xác theo từ | Ngữ nghĩa, theo khoảng cách vector |
| Từ đồng nghĩa | Phải khai báo tay | Nhận được nếu model đủ tốt |
| Mã, số chính xác | Rất tốt: "HĐ-2026-118" | Yếu, dễ trượt |
| Chi phí, độ trễ | Rẻ, nhanh, không cần GPU | Đắt hơn: model, kho vector, ANN |
| Cập nhật chỉ mục | Thêm tài liệu ngay, không cần embed lại | Phải embed tài liệu mới; đổi model phải index lại toàn bộ |
| Giải thích được | Rõ từ khóa nào làm tài liệu trúng | Khó; chỉ có khoảng cách vector |
| Đa ngôn ngữ | Kém nếu không chuẩn hóa hoặc thêm từ điển | Tốt với model đa ngôn ngữ |
BM25 mạnh ở đâu
Một: tần suất bão hòa. Từ xuất hiện 10 lần không khớp gấp 10 lần so với từ xuất hiện một lần. BM25 nén phần tăng bằng hàm log nên điểm tăng chậm dần.
Hai: trọng số ngược độ hiếm. "Hợp đồng" ở mọi tài liệu nên không phân biệt được gì; "HĐ-2026-118" ở đúng một tài liệu thì vô cùng quý.
Ba: chuẩn hóa theo độ dài. Tài liệu dài trúng từ khóa nhiều hơn nên BM25 chia điểm cho chúng một hệ số điều chỉnh.
Ba cơ chế này giải thích vì sao BM25 vẫn là mặc định cho tìm kiếm từ khóa: công thức Okapi BM25 trên Wikipedia ghi rõ từng thành phần.
Vì sao thực tế dùng hybrid
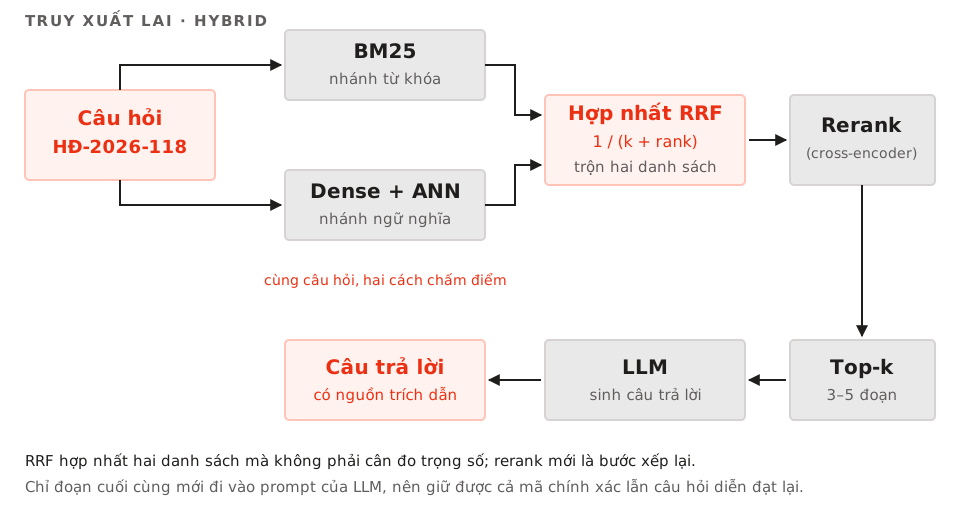
Chọn một cách, bạn thường thua ở một nhóm câu hỏi. Thực tế người ta chạy cả hai rồi trộn kết quả — hybrid search (tìm kiếm lai).
Cách trộn phổ biến nhất là RRF (Reciprocal Rank Fusion): mỗi tài liệu nhận điểm bằng tổng các 1/(k + thứ hạng), với k thường lấy 60. Công thức này chỉ cần thứ hạng nên không phải chuẩn hóa thang điểm giữa BM25 và cosine. Cách thứ hai là cộng trọng số α cho điểm BM25 và β cho điểm cosine, rõ hơn nhưng phải tinh chỉnh trên câu hỏi thật.
Sau khi trộn, thêm bước rerank: mô hình chấm điểm lại từng cặp câu hỏi và đoạn văn — chậm hơn nhưng chính xác hơn — rồi mới cắt lấy top-k đoạn đưa vào prompt; cross-encoder là gì đi sâu vào bước này. Phía dense cũng cải thiện được trước khi tìm kiếm: kỹ thuật HyDE trong RAG cho LLM viết trước một đoạn giả định rồi nhúng đoạn đó.
Chọn cách nào cho kho của bạn
- Mã số, SKU, tên điều khoản, số hợp đồng → sparse.
- Câu hỏi tự nhiên, diễn đạt lại → dense.
- Kho hỗn hợp cả hai loại câu hỏi → hybrid, và đây là mặc định nên dùng.
- Kho rất nhỏ, vài chục tài liệu → đừng xây gì: nhét thẳng tài liệu vào prompt.
- Nhiều ngôn ngữ trong cùng kho → dense với model đa ngôn ngữ, cộng sparse để giữ mã và tên riêng.
Nếu bạn cần người triển khai thay vì tự làm, đội ngũ phát triển phần mềm của Cross Tech Edu nhận thiết kế, xây và vận hành hệ thống RAG.
Đo và vận hành
Đừng chọn theo cảm tính, hãy đo trên bộ câu hỏi vàng 20–50 câu, mỗi câu gắn sẵn đoạn tài liệu đúng.
- recall@k: trong k đoạn lấy ra có chứa đoạn đúng không — RAG chỉ dùng được những gì đã truy xuất.
- nDCG: đoạn đúng xếp hạng cao không, chứ không chỉ có mặt.
- Độ trễ, chi phí: đo riêng phần nhúng câu hỏi và phần tìm kiếm.
- Tần suất cập nhật chỉ mục: bao lâu một tài liệu mới xuất hiện trong kết quả.
Ba nguyên tắc vận hành cho cả hai bên:
- Chunking ảnh hưởng tới cả hai. Chunk quá nhỏ thì BM25 mất ngữ cảnh, vector kém ổn định; quá lớn thì lẫn nội dung. Cắt theo ranh giới câu, chồng lấn 10–15%.
- Dùng cùng model embedding cho index và truy vấn. Đổi model mà không index lại là lỗi âm thầm: không báo lỗi, chỉ ra kết quả tệ.
- Chuẩn hóa vector (L2) trước khi dùng dot product để điểm số quy về cosine; nếu không, vector có norm lớn sẽ chiếm ưu thế.
Lưu ý cho tiếng Việt
- Dấu thanh. "Đổi trả" và "doi tra" là hai chuỗi khác nhau với BM25. Chuẩn hóa bỏ dấu ở cả index và truy vấn, giữ bản gốc để hiển thị.
- Cách tách từ quyết định chất lượng BM25. Tách bằng khoảng trắng tệ hơn nhiều so với bộ tách từ có xử lý dấu; tokenizer subword của LLM thì cắt vụn từ khóa.
- Embedding đa ngôn ngữ, không phải model tiếng Anh. Model chỉ huấn luyện tiếng Anh kém rõ rệt ở tiếng Việt; chọn model đa ngôn ngữ rồi index lại kho.
- Khai báo cặp từ đồng nghĩa bằng tay. "Đổi trả" và "hoàn hàng", "hủy đơn" và "huỷ đơn" — đưa các biến thể này vào truy vấn mở rộng hoặc vào chỉ mục.
Câu hỏi thường gặp
Dense có thay thế BM25 không?
Không hoàn toàn. Dense thắng ở câu hỏi diễn đạt lại, BM25 thắng ở mã và thuật ngữ hiếm. Nếu chỉ chọn một, hãy bắt đầu bằng BM25 vì rẻ và dễ vận hành hơn.
Có cần vector database riêng không?
Không bắt buộc. Với vài nghìn chunk, một thư viện tìm kiếm vector nhúng trong ứng dụng là đủ, và nhiều dịch vụ AI có sẵn kho vector theo gói. Cân nhắc kho riêng khi tài liệu lớn, nhiều người hỏi đồng thời, hoặc cần độ trễ ổn định.
Sparse có phải keyword search không?
Không hẳn. Sparse retrieval là cách biểu diễn văn bản thành vector thưa (túi từ); keyword search là ứng dụng dùng cách biểu diễn đó. BM25 là một hàm chấm điểm cụ thể cho sparse retrieval, không phải toàn bộ hệ thống tìm kiếm. Điểm chung: cả hai đều không hiểu nghĩa.
Kết luận
Sparse đếm từ, dense đo nghĩa, và RAG thực tế dùng cả hai. Nếu đang bắt đầu: dựng BM25 trước vì gần như miễn phí; thêm nhánh dense khi câu hỏi diễn đạt lại bị trượt; trộn bằng RRF rồi rerank; sau đó đo bằng bộ câu hỏi vàng của chính bạn. Chưa cần tự xây thì xem bài tổng hợp các công cụ AI miễn phí.