
HyDE là gì? Tìm tài liệu thật bằng tài liệu giả định
HyDE là gì? Cách LLM viết tài liệu giả định để tìm tài liệu thật: cơ chế, pipeline, tham số, cách đo hiệu quả và lúc nào nên bật cho cửa hàng bán lẻ ngay.

HyDE (Hypothetical Document Embeddings) cải thiện phần truy xuất của RAG. Bài gốc: Precise Zero-Shot Dense Retrieval without Relevance Labels (Gao, Ma, Lin và Callan, 2022) — bài báo HyDE trên arXiv.
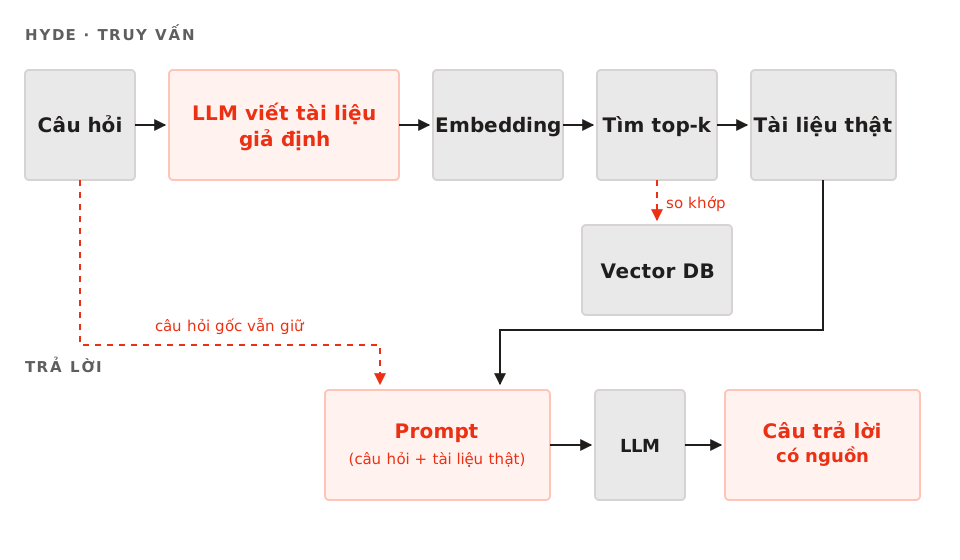
HyDE không sinh câu trả lời, không thay thế RAG. Nó thay một bước: nhúng tài liệu giả định do LLM viết thay cho câu hỏi, rồi tìm tài liệu thật bằng vector đó.
Chưa nắm RAG thì đọc giải thích RAG cho doanh nghiệp nhỏ; cần công cụ dùng ngay thì xem công cụ AI miễn phí cho doanh nghiệp nhỏ.
HyDE nằm ở đâu trong RAG?
RAG có hai vế: truy xuất (tìm đoạn liên quan) và sinh (viết câu trả lời từ các đoạn đó). Hệ thống chạy hai pha:
- Chỉ mục (offline): cắt chunk, embed, lưu kho vector.
- Truy vấn (online): embed câu hỏi, tìm top-k chunk, ghép vào prompt, để LLM trả lời.
HyDE can thiệp ở một chỗ trong pha truy vấn: thay vector câu hỏi bằng vector của tài liệu giả định. Kho vector, model embedding, top-k và prompt giữ nguyên.
Định nghĩa chính xác: tài liệu giả định là gì?
Cho một câu hỏi, LLM làm theo chỉ dẫn viết ra một tài liệu giả định trả lời câu hỏi đó; encoder học tương phản không giám sát (ví dụ Contriever) nhúng nó thành vector; vector đó tìm tài liệu thật trong kho.
Bài báo nói thẳng: tài liệu giả định "nắm bắt được các mẫu liên quan nhưng không có thật và có thể chứa chi tiết sai", nên nó dùng để tìm kiếm, không để trả lời.
Vì sao thứ "sai" lại hiệu quả? Ở giữa có cái phễu: encoder nén văn bản thành vector theo nghĩa nên chi tiết sai bị loại, còn chủ đề và thuật ngữ sống sót. Vector cuối cùng bị neo về kho thật.
Tại sao HyDE lại hiệu quả?
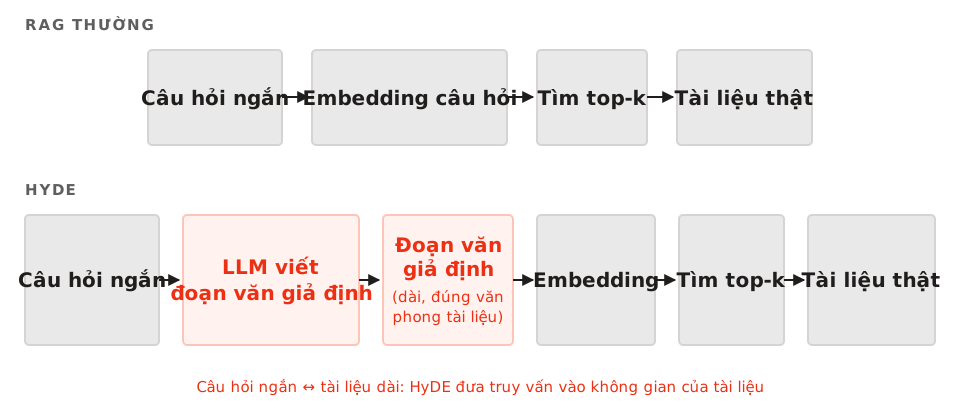
- Câu hỏi ngắn, tài liệu dài. "Đổi trả sau mấy ngày?" là năm token; đoạn chính sách là hai trăm token. Hai vector xa nhau.
- Vector câu hỏi nằm ngoài phân phối. Encoder quen dạng điểm tài liệu, không quen dạng điểm câu hỏi — đây là lý do dense zero-shot kém BM25.
- HyDE đưa câu hỏi vào không gian tài liệu. Tài liệu giả định có hình dạng của tài liệu, nên vector rơi vào vùng encoder "quen nghe".
Hệ quả: tài liệu giả định không cần đúng sự thật, chỉ cần giống tài liệu: ngôn ngữ, độ dài, cấu trúc, thuật ngữ.
Pipeline từng bước: ví dụ chính sách đổi trả
Kho tài liệu gồm chính sách đổi trả, FAQ giao hàng và quy trình hoàn tiền. Người dùng hỏi: "Khách mua online đổi trả trong bao lâu, có mất phí không?"
Bước 1: LLM sinh tài liệu giả định
Mẫu prompt, rút gọn theo bài báo:
Please write a short passage to answer the question.
Try to include as many key details as possible.

Question: {câu hỏi}
Passage:
Đầu ra có thể là: "Khách mua online được đổi trả trong vòng 14 ngày. Phí đổi trả là 30.000đ, miễn phí nếu sản phẩm bị lỗi."
Con số 30.000đ có thể sai, có chủ đích: tài liệu giả định cần đúng chủ đề và dạng văn bản, không cần đúng số liệu.
Bước 2: Nhúng tài liệu giả định
Đi qua đúng encoder đã dùng để index kho. Lệch model thì kho và câu hỏi rơi vào hai không gian khác nhau.
Bước 3: Tìm tài liệu thật
Vector đó so với kho vector, lấy top-k tài liệu thật gần nhất, thường k = 3 đến 5: ở đây là đoạn chính sách đổi trả.
Bước 4: Trả lời từ tài liệu thật
Prompt trả lời của RAG thường: câu hỏi, các đoạn vừa truy xuất, yêu cầu trích dẫn nguồn. Câu trả lời sinh từ tài liệu thật, nên 14 ngày hay 30.000đ trong tài liệu giả định không quyết định gì.
Mã giả cho pipeline này
def answer(query, corpus, generator, encoder):
    hypothetical = generator.write(prompt=HYDE_PROMPT.format(query=query))
    vector = encoder.embed(hypothetical)
    passages = corpus.search(vector, top_k=5)
    return generator.answer(query, passages)
HYDE_PROMPT là mẫu prompt ở trên; dòng đầu tốn thêm một lượt gọi LLM mỗi câu hỏi.
RAG thường và HyDE khác nhau ở đâu?
| RAG thường | HyDE | |
|---|---|---|
| Cái được nhúng | Câu hỏi người dùng | Tài liệu giả định do LLM sinh |
| Thêm lượt gọi LLM? | Không | Có, mỗi câu một lượt |
| Mạnh ở | Câu hỏi bám sát từ ngữ tài liệu | Câu hỏi diễn đạt lại, zero-shot |
| Yếu ở | Câu hỏi ngắn, từ ngữ lệch | Khớp chính xác, dữ liệu bảng |
Nói thẳng: HyDE không thay thế RAG. Câu trả lời vẫn sinh từ tài liệu thật. HyDE đổi vector đầu vào của bước tìm kiếm, không đổi nguồn kiến thức.
Tham số và biến thể
- Một hay nhiều: sinh nhiều tài liệu giả định rồi trung bình vector để giảm nhiễu; ba đến năm ổn định hơn một.
- Temperature: thấp (0–0.3) khi câu hỏi rõ hướng, cao hơn (0.5–0.8) khi mơ hồ; quá cao thì tài liệu giả định trôi chủ đề.
- Max tokens: khoảng 150–300; quá dài thì lan chủ đề khác, quá ngắn thì giống câu hỏi.
- Model sinh: model nhỏ rẻ hơn nhưng sinh tài liệu giả định yếu với thuật ngữ chuyên ngành.
- Ngôn ngữ sinh: phải khớp ngôn ngữ kho — kho tiếng Việt thì sinh tiếng Việt.
- Caching: câu hỏi lặp lại sinh tài liệu giả định một lần rồi tái dùng, cắt gần hết chi phí LLM.
- Vector câu hỏi gốc: trung bình với vector tài liệu giả định, hoặc chỉ dùng vector đó; trung bình an toàn hơn khi kho nhỏ.
Đo hiệu quả thế nào?
Bộ câu hỏi vàng: 20–50 câu, mỗi câu gắn đoạn tài liệu đúng. Chạy hai cấu hình trên cùng kho, model và top-k.
- recall@k: bao nhiêu câu có đoạn đúng trong k đoạn lấy ra? HyDE cải thiện rõ nhất ở đây.
- nDCG: đoạn đúng có xếp hạng cao không; quan trọng khi top-k nhỏ và context bị cắt.
- Độ trễ và chi phí: HyDE thêm một lượt gọi LLM, phần tăng lớn nhất.
- Phân tích lỗi: đọc 10–20 câu bị trượt, gom nguyên nhân: câu hỏi quá ngắn, tài liệu giả định trôi chủ đề, chunk sai, kho không có đáp án.
Kết quả công bố: HyDE vượt Contriever zero-shot (bản không cần fine-tune) và ngang với retriever đã fine-tune trên tìm kiếm web, hỏi đáp, kiểm chứng sự thật, truy xuất đa ngôn ngữ. Không có con số chung: tự đo.
Khi nào HyDE giúp, khi nào gây hại
HyDE hữu ích khi: câu hỏi mơ hồ hoặc diễn đạt lại; tài liệu kho dùng từ ngữ khác câu hỏi; chưa có retriever đã fine-tune và cần zero-shot tốt hơn; truy xuất đa ngôn ngữ.
HyDE vô nghĩa hoặc có hại khi:
- Tra cứu khớp chính xác: mã SKU, số hoá đơn — BM25 khớp ký hiệu tốt hơn nhiều.
- Dữ liệu số hoặc dạng bảng: biểu giá, báo cáo tài chính; văn bản giả định không mô tả được cấu trúc.
- Ngân sách độ trễ hoặc chi phí bị chặt: mỗi câu hỏi thêm một lượt gọi LLM.
- Kho rất nhỏ, vài chục tài liệu: tài liệu đã vừa prompt, tìm kiếm không còn ý nghĩa.
- Retriever đã fine-tune rất tốt trong miền của bạn: chi phí bổ sung không còn đáng.
- Encoder chỉ hỗ trợ một ngôn ngữ trong khi câu hỏi và tài liệu khác ngôn ngữ.
Cách an toàn là tìm kiếm lai (hybrid): BM25 cho khớp chính xác, dense có HyDE cho câu hỏi diễn đạt lại, rồi rerank bằng cross-encoder. Bài so sánh kết hợp dense và sparse đi sâu hơn vào cách hợp nhất kết quả hai bên.
Áp dụng HyDE cho tiếng Việt
- Sinh tài liệu giả định bằng tiếng Việt: vector phải nằm trong không gian của kho tiếng Việt.
- Embedding model đa ngôn ngữ hỗ trợ tiếng Việt tốt, và index lại kho bằng đúng model đó; lệch model là lỗi âm thầm.
- Vẫn cần BM25 cho mã số, thuật ngữ hiếm, tên riêng có dấu: "Điều 5", "HĐ-2026-118" — dense retrieval hay trượt vì chuỗi này không mang nghĩa.
- Dấu thanh và thuật ngữ miền: tokenizer có thể tách từ tiếng Việt khác kỳ vọng; tài liệu giả định phải dùng thuật ngữ gốc.
- Generator yếu giới hạn mọi lợi ích: LLM sinh tài liệu giả định tiếng Việt kém thì HyDE không giúp được gì, nên hệ thống dùng LLM lớn cho bước này.
Câu hỏi thường gặp
HyDE có bịa (hallucinate) không?
Có, và bài báo nói thẳng tài liệu giả định "không có thật và có thể chứa chi tiết sai". Nhưng nó không đi thẳng vào câu trả lời, chỉ là đầu vào cho bước tìm kiếm. Rủi ro thật là gián tiếp: tài liệu giả định sai kéo top-k về nhầm chủ đề, và tài liệu thật ở đó sinh câu trả lời sai.
HyDE có thay thế RAG không?
Không. HyDE là kỹ thuật bên trong RAG, thay đổi cách tính vector truy vấn. Bỏ HyDE thì hệ thống vẫn là RAG; bỏ RAG thì chỉ còn tìm kiếm vector.
Có cần fine-tune không?
Không bắt buộc. HyDE được thiết kế cho trường hợp không có nhãn liên quan (zero-shot), nên hợp với đội không có dữ liệu huấn luyện. Nếu đã fine-tune retriever, hãy so sánh bằng câu hỏi vàng trước.
Kết luận
HyDE là thay đổi nhỏ về mã: thay vì nhúng câu hỏi, hãy nhúng một tài liệu giả định do LLM viết, rồi dùng vector đó để tìm tài liệu thật. Nó không thay thế RAG và tốn thêm một lượt gọi LLM mỗi câu hỏi.
Bật nó khi câu hỏi mơ hồ và kho dùng từ ngữ khác bạn; tắt nó khi cần khớp chính xác, dữ liệu dạng bảng, hoặc ngân sách chặt. Đo trước khi tin. Muốn công cụ chạy được ngay thì xem bài tổng hợp các công cụ AI miễn phí.